Developers
Cómo actualizamos el corazón de nuestra plataforma de pagos sin detener un solo segundo el servicio

Share

Actualizar la base de datos que sostiene una plataforma de pagos es, en muchos sentidos, como cambiar el motor de un avión en pleno vuelo: hay que hacerlo sin que los pasajeros se vean afectados, y con la capacidad de volver al motor anterior en segundos si algo no sale como se esperaba.
Eso es exactamente lo que hicimos con la base de datos más crítica de Pomelo: el corazón de nuestra plataforma de pagos.
El problema: no hay pausa posible en los pagos
Cada segundo que un sistema de pagos está caído no es solo un número en un dashboard. Es una transacción que no se completa, un comercio que no cobra, una tarjeta que no autoriza. En una plataforma como la nuestra, que procesa pagos en tiempo real 24/7, simplemente no existe la opción de decir "volvemos en 20 minutos, estamos actualizando la base".
Sin embargo, esa base de datos necesitaba una actualización mayor: pasar a la última versión del motor y generación de hardware disponibles. Es el tipo de cambio que, en la mayoría de las empresas, implica una interrupción del servicio: aunque sea breve, aunque sea de madrugada, aunque esté bien comunicada de antemano.
Nosotros nos propusimos hacerlo de otra manera: sin interrumpir el servicio, sin perder una sola transacción, y con la posibilidad de revertir el proceso en cualquier momento si algo no salía como esperábamos. Tres condiciones que, combinadas, muy pocos equipos en la industria logran cumplir al mismo tiempo.
Por qué el camino "fácil" no nos servía
Cuando empezamos a diseñar la solución, evaluamos primero las herramientas que existen específicamente para este tipo de migraciones. La más obvia, Amazon RDS Blue/Green Deployments, pensada justamente para actualizar bases de datos en forma automática, tenía dos problemas concretos para nuestro caso: primero, aunque automatiza gran parte del proceso, el cambio final implica una interrupción de al menos algunos minutos. Segundo, es incompatible con mecanismos de replicación a sistemas externos, como nuestro Data Lake. Cualquiera de los dos, por sí solo, ya era razón suficiente para descartarla.
La segunda alternativa, pglogical, tenía dos incompatibilidades igual de definitivas: no soportaba crear el ambiente destino a partir de un snapshot, y la versión del plugin disponible en la base origen era incompatible con la versión a la que queríamos migrar, lo que hacía imposible configurar la replicación entre ambas.
Con las dos rutas conocidas cerradas, tuvimos que construir nuestro propio camino.
La solución: dos bases gemelas, sincronizadas en tiempo real
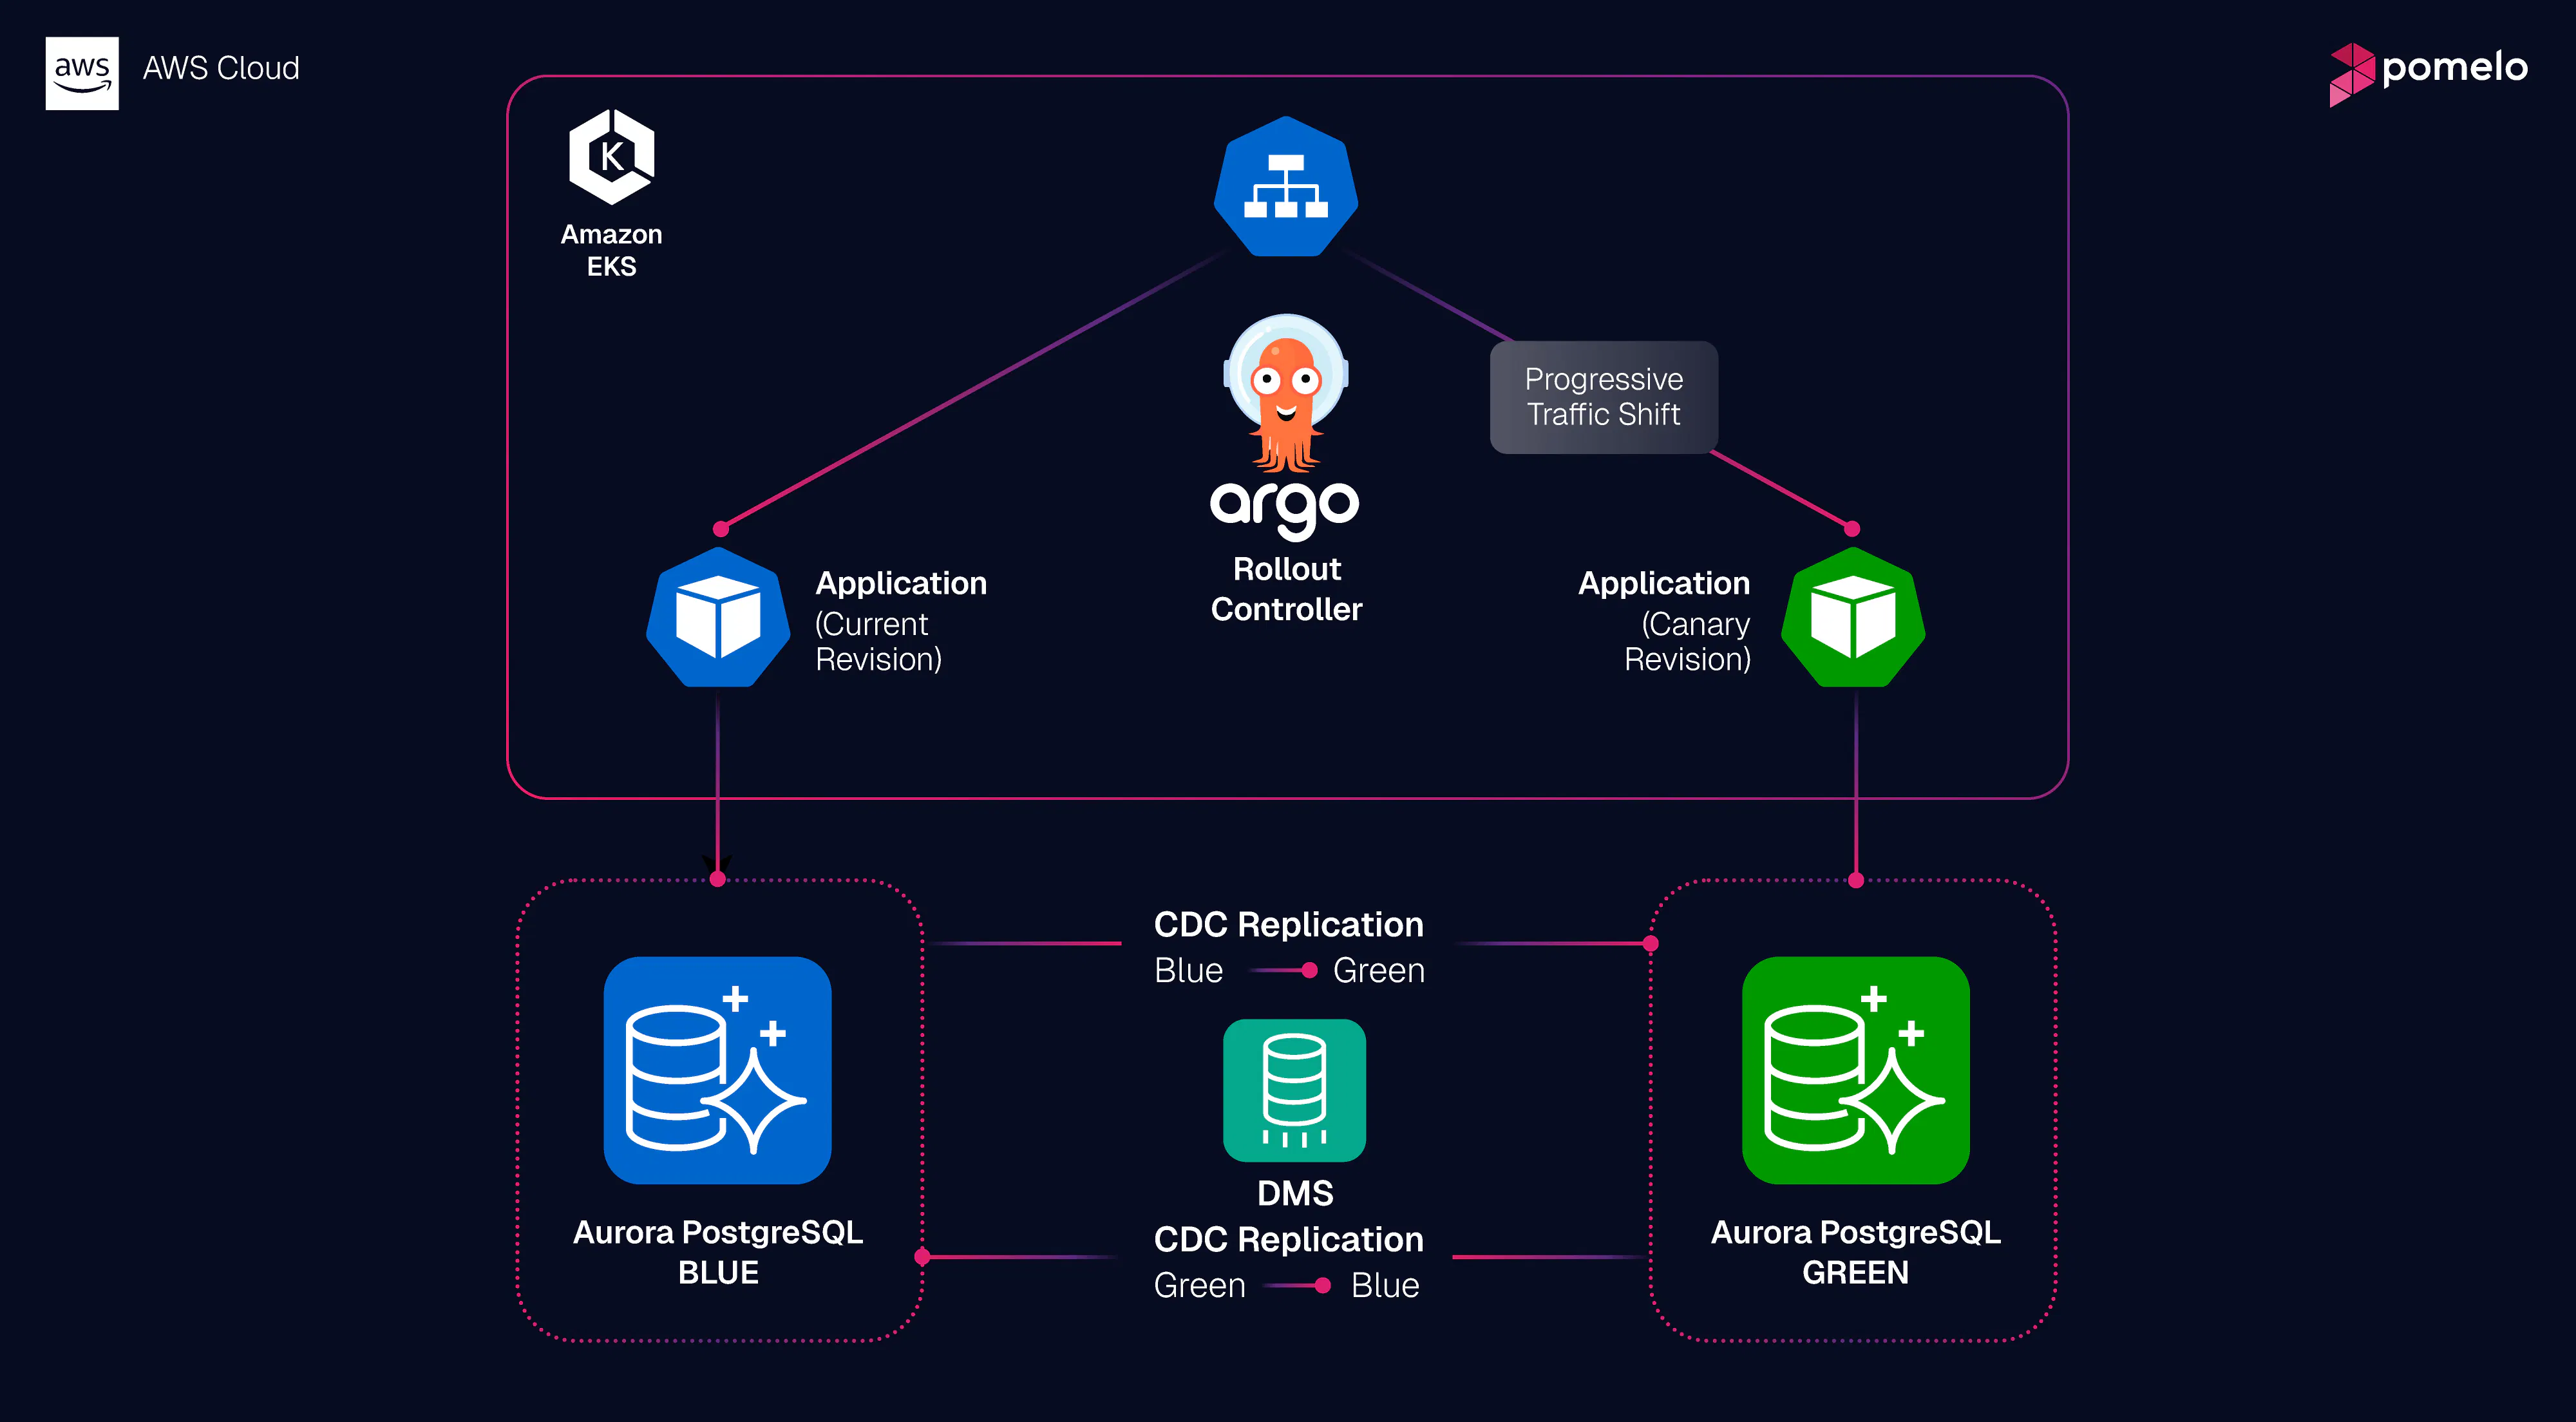
La idea central fue simple de explicar, aunque compleja de ejecutar: implementamos una estrategia de Blue/Green Deployment con replicación bidireccional utilizando AWS Database Migration Service. En lugar de un corte abrupto, las dos bases operaron en paralelo durante toda la transición, con replicación continua y rollback disponible en todo momento.
El proceso, en términos simples, fue el siguiente:
 Tomamos una foto exacta de la base origen (Blue) en un instante preciso.
- A partir de esa foto, construimos la nueva base (Green), ya en la versión moderna y sobre el hardware actualizado al que queríamos migrar.
- Conectamos ambas con un mecanismo de replicación que copiaba en tiempo real todo lo que ocurría en Blue hacia Green: cada pago, cada registro, cada actualización.
- Cuando confirmamos que Green estaba perfectamente sincronizada y funcionando, activamos la replicación en sentido inverso: de Green hacia Blue. Esto es el núcleo de toda la estrategia, aunque empezáramos a mover tráfico real hacia la nueva base, la base origen seguía recibiendo una copia de los datos. Volver atrás, en cualquier momento y sin perder un dato, seguía siendo una opción.
Con esa red de contención tendida, recién ahí empezamos a mover tráfico de verdad.
El cutover: una migración progresiva y monitoreada
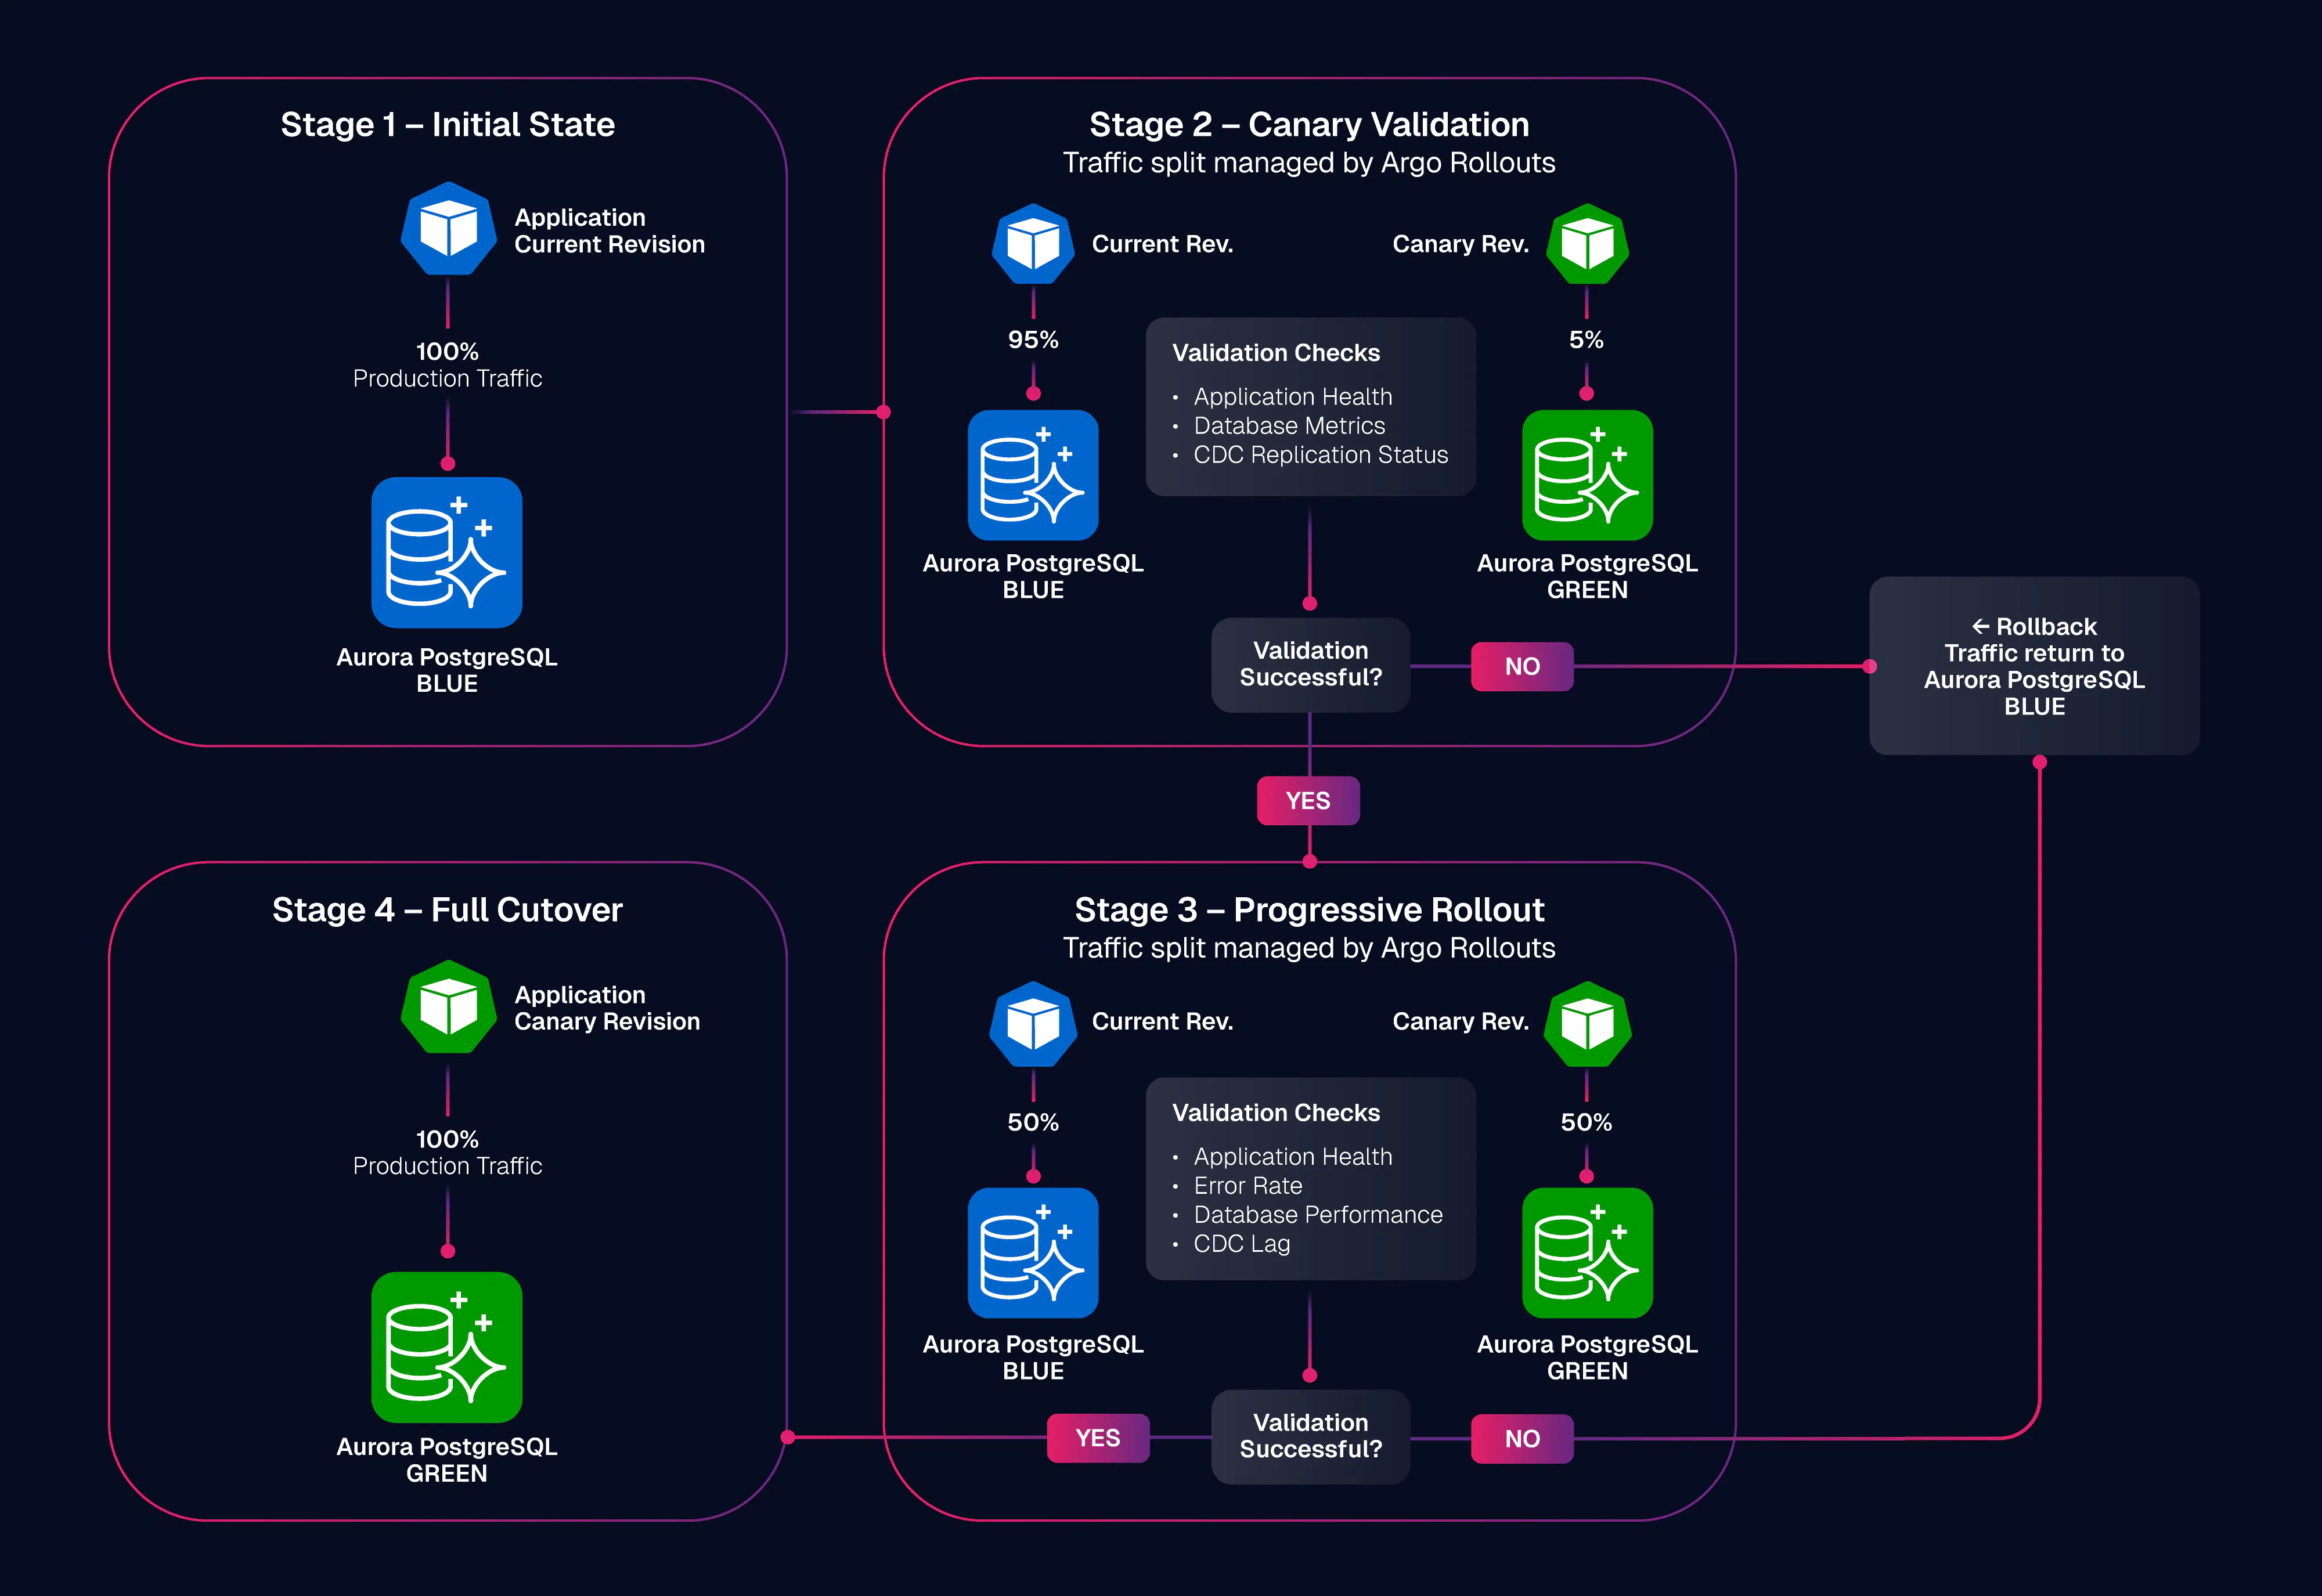
En lugar de un cambio de todo o nada, migramos el tráfico de forma gradual y controlada, utilizando Argo Rollouts. Primero, un 5% de las operaciones reales pasaron a usar la base nueva, mientras el 95% restante seguía en la base origen. Monitoreamos todo: la salud de la aplicación, la velocidad de respuesta, el estado de la sincronización entre ambas bases, cualquier error o señal de alarma.
Superada esa primera validación, fuimos incrementando el porcentaje: 10%, 25%, 50%, 75%, hasta llegar al 100%. En cada paso, ante cualquier señal de degradación, podíamos detener la migración y redirigir todo el tráfico a la base de origen en segundos, sin impacto para nuestros clientes.
Recién cuando el 100% del tráfico llevaba el tiempo suficiente para validar la estabilidad, dimos por cerrado el proceso: apagamos las replicaciones, desmontamos la base origen y dejamos la infraestructura completamente modernizada.
Los números que lo justifican
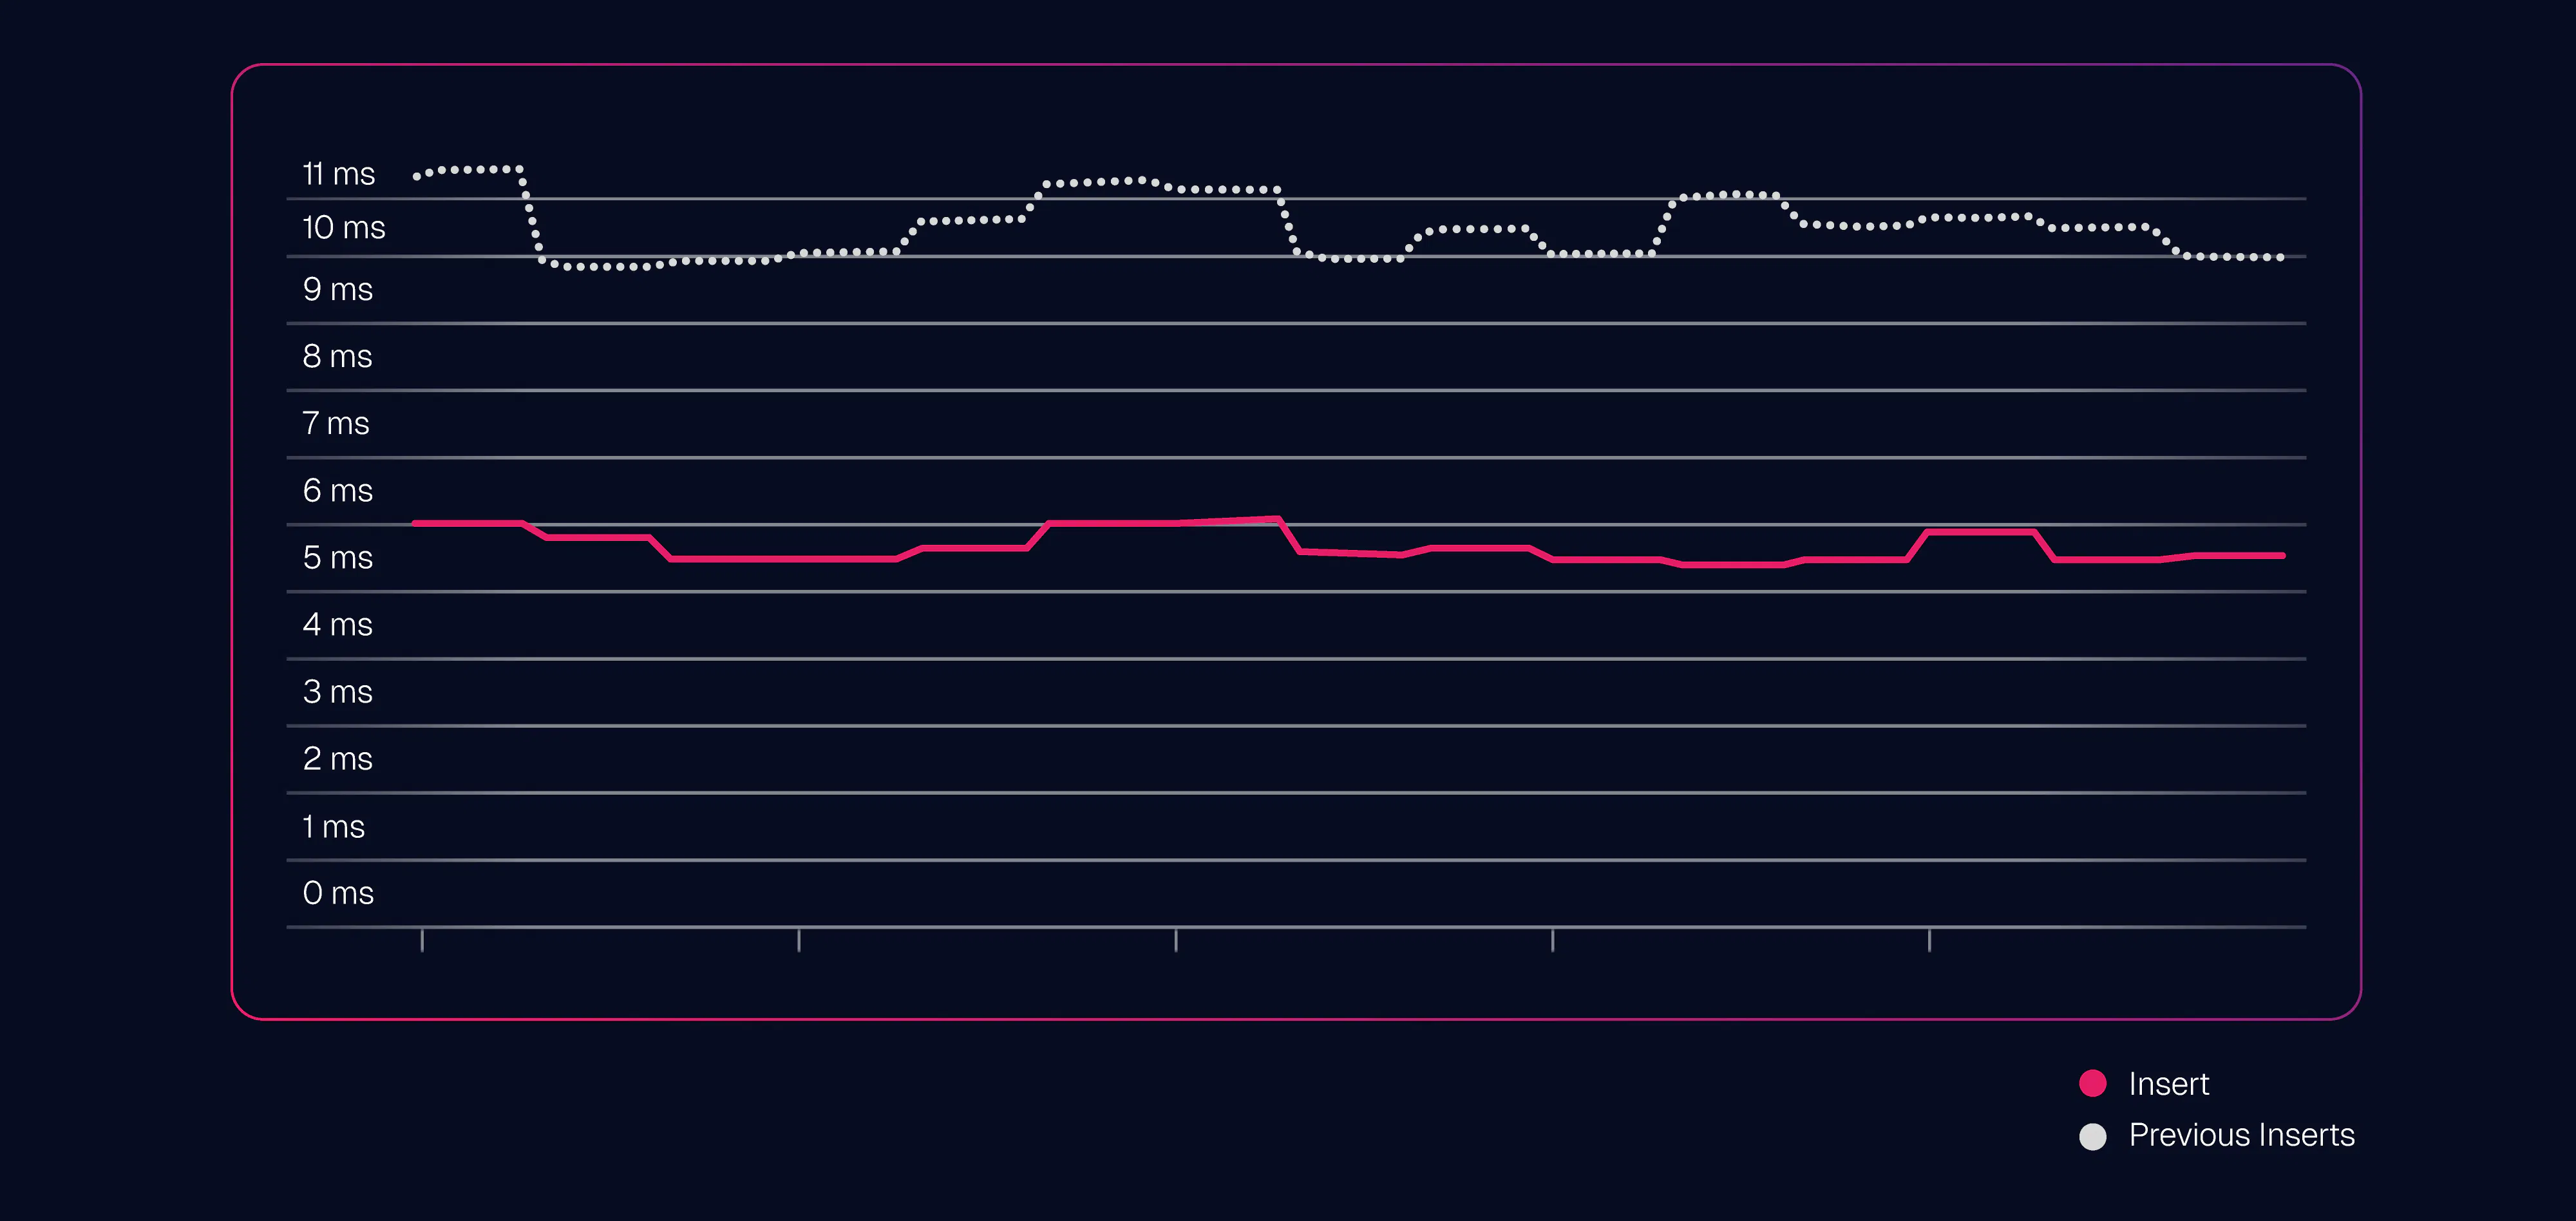
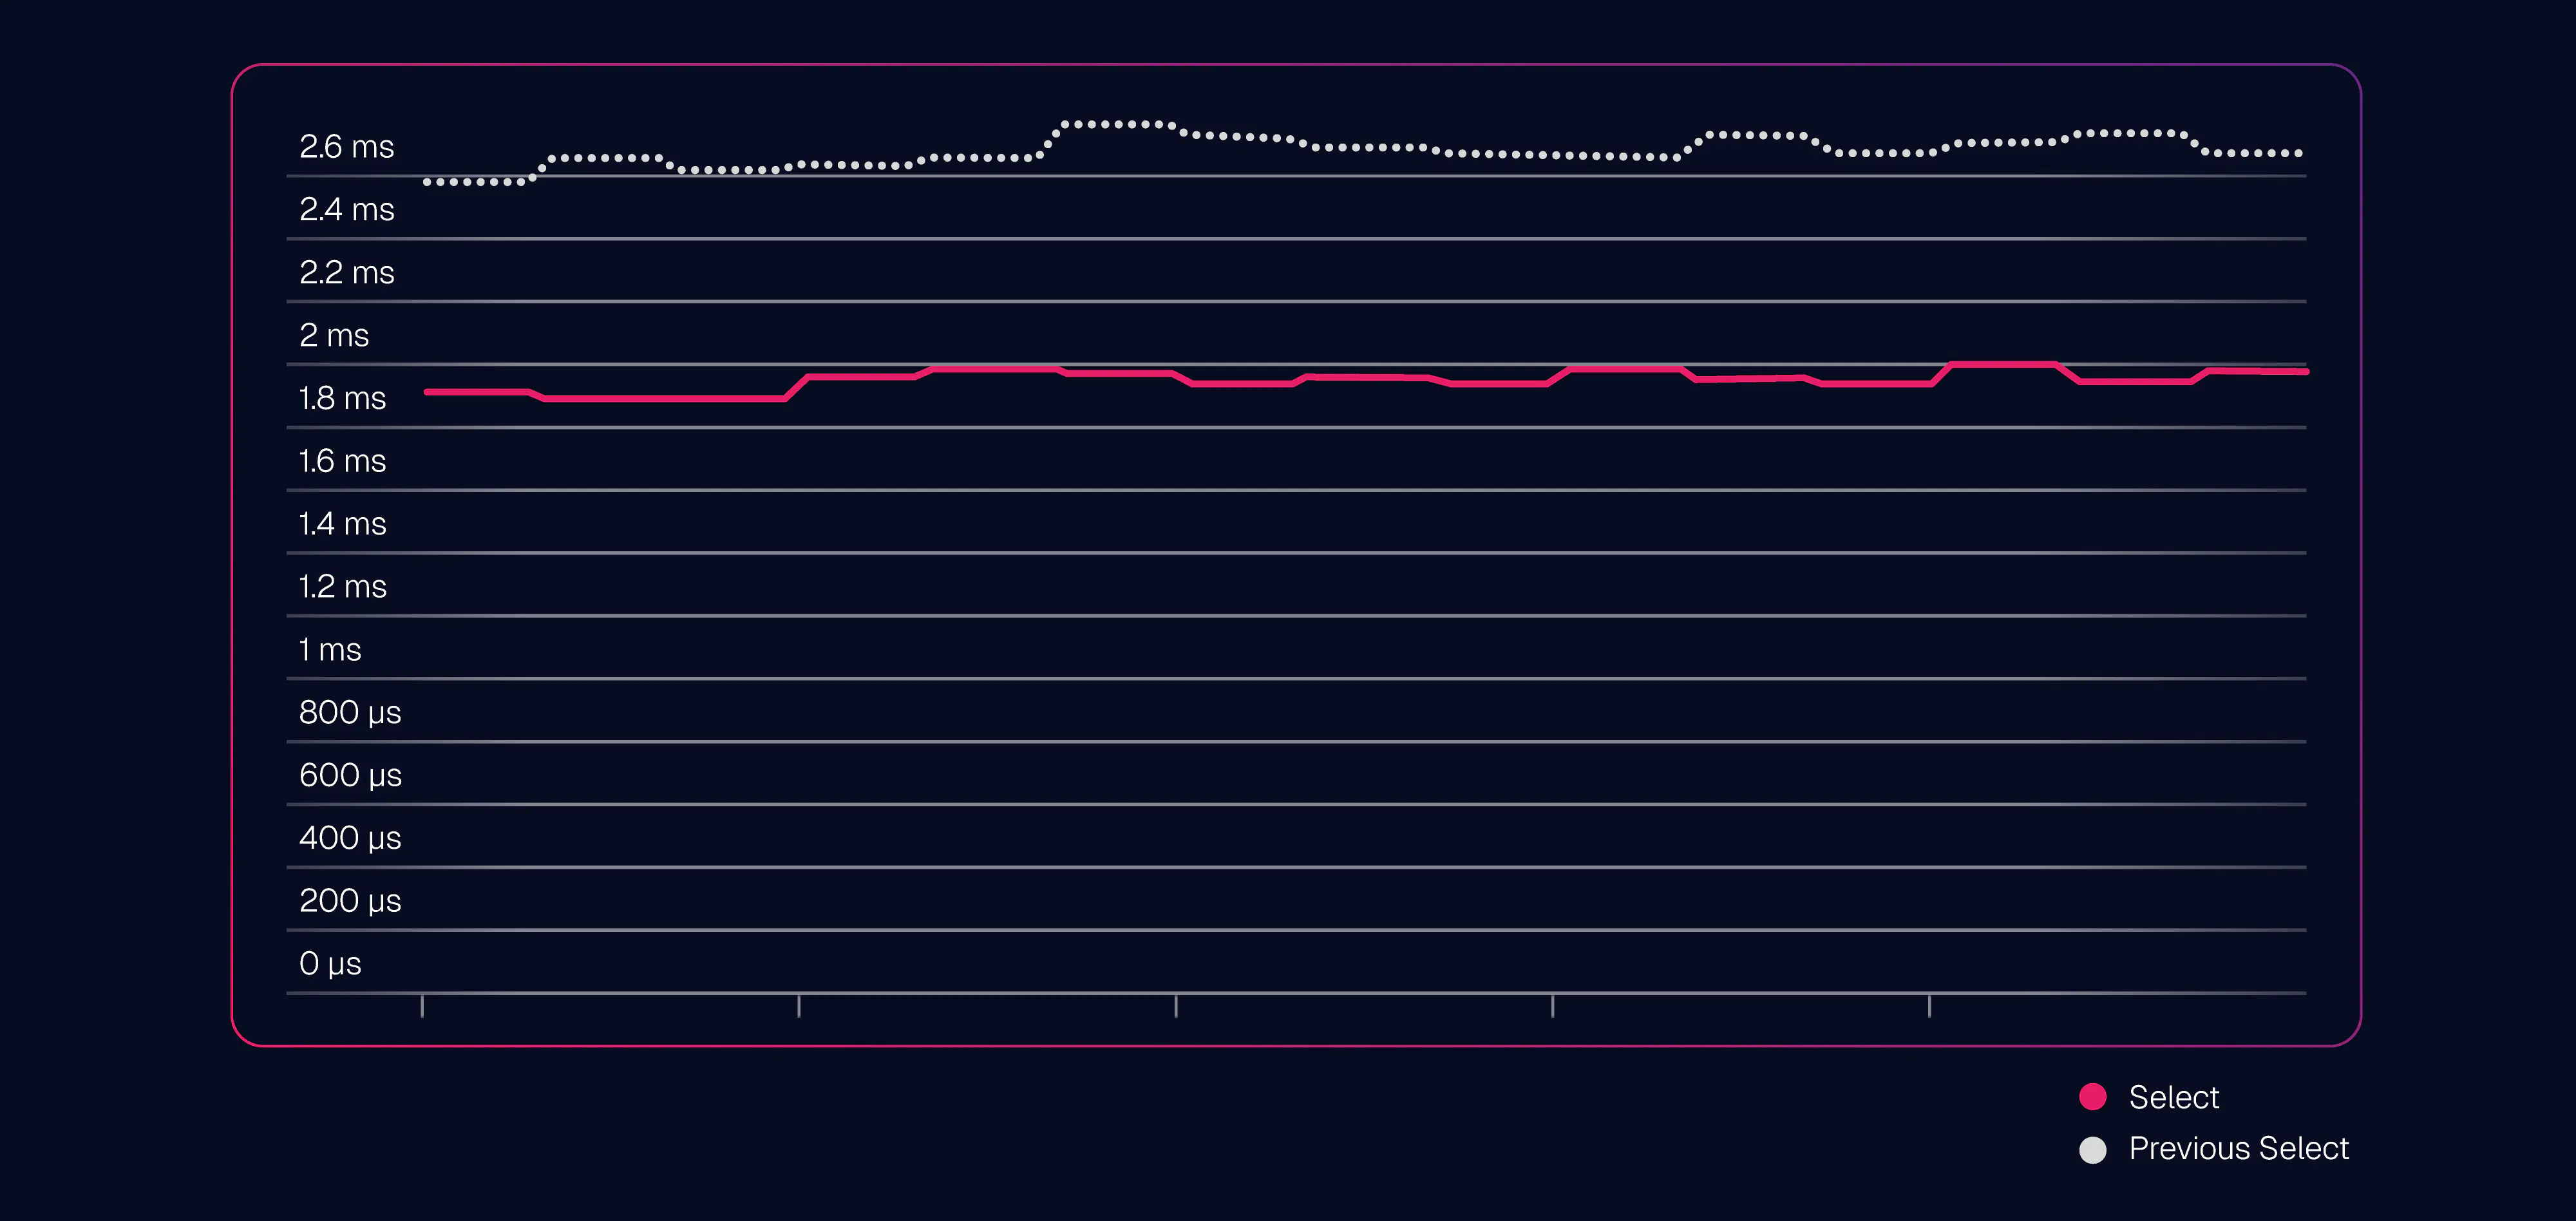
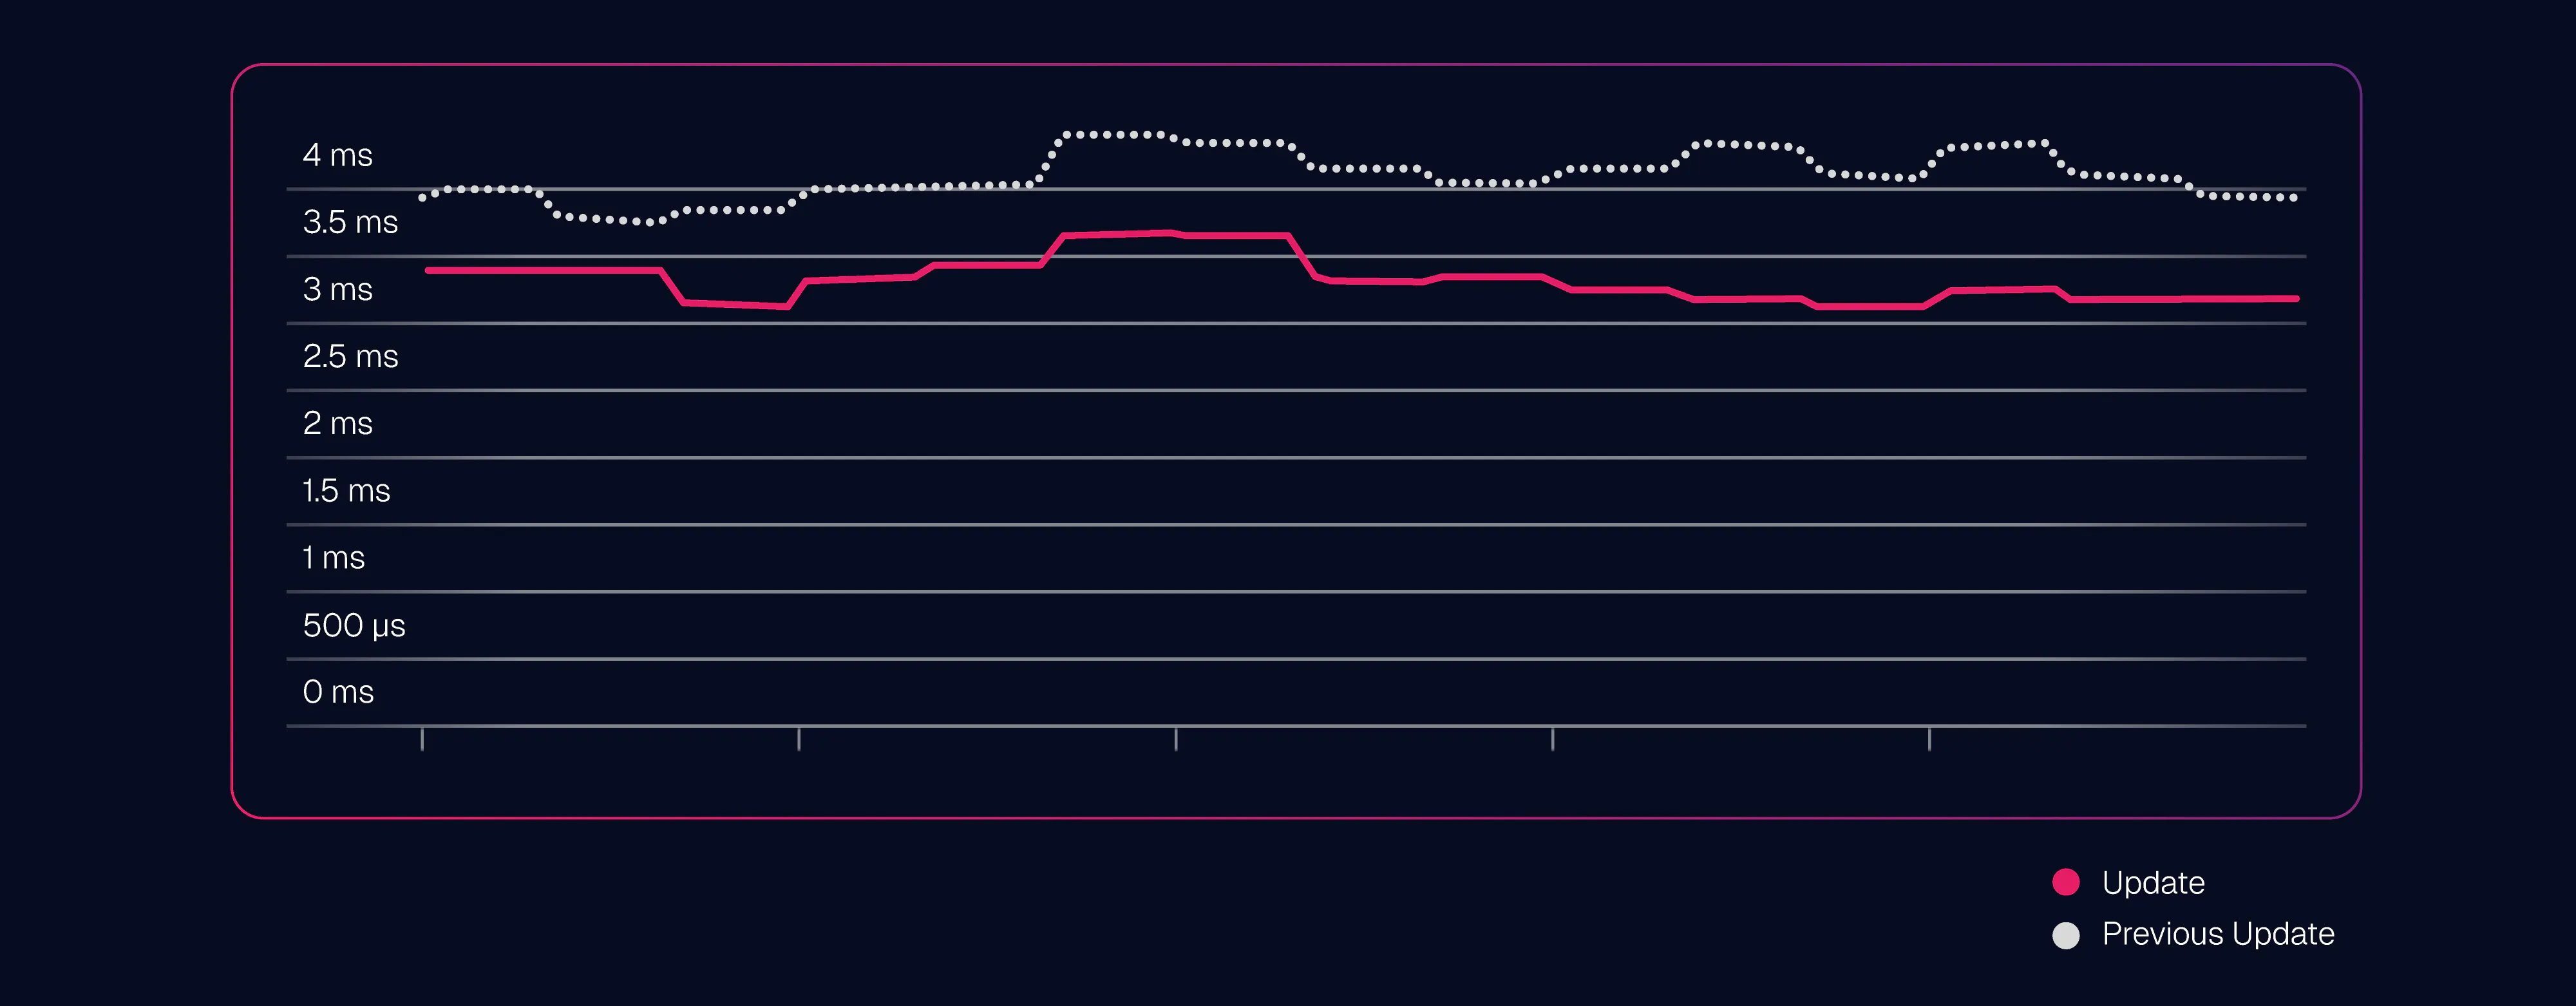
Todo este esfuerzo de ingeniería no fue solo por prolijidad técnica. La combinación de actualizar el motor de base de datos y migrar a instancias Graviton4 se tradujo en mejoras concretas de performance que sentimos en producción:
Las operaciones de inserción de datos se volvieron un 45% más rápidas.
Las consultas de lectura mejoraron un 30%.
Las actualizaciones de registros existentes ganaron un 20% de velocidad.
Y todo esto ocurrió mientras la plataforma seguía procesando pagos reales, sin pausas, sin errores y sin ninguna interrupción para nuestros clientes.
Lo que nos llevamos de esta experiencia
Además de la mejora de performance, este proyecto nos deja algunas lecciones claras como equipo de ingeniería:
- Es posible actualizar infraestructura crítica sin sacrificar disponibilidad, si se invierte el tiempo necesario en diseñar una estrategia con un rollback genuino, no solo un plan de contingencia en un documento.
- La clave para animarse a este tipo de proyectos no es la ausencia de riesgo, sino tener siempre una puerta de salida abierta: en nuestro caso, la posibilidad de volver atrás en cualquier momento, sin perder un solo dato.
- Estos procesos exigen coordinación entre equipos, pruebas exhaustivas antes de tocar producción, y la capacidad de detectar cualquier desvío antes de que se convierta en un problema real.
Este tipo de desafíos son parte del día a día de construir una plataforma de pagos de primer nivel como Pomelo: infraestructura que nunca puede parar, pero que tampoco puede quedarse atrás.
Si te interesa el detalle técnico completo, arquitectura, herramientas de AWS y configuraciones específicas, publicaremos próximamente la guía técnica extendida para equipos de ingeniería.
Este proyecto fue posible gracias al trabajo del equipo de ingeniería de Pomelo, en colaboración con AWS.